Mehr als 20.000 innovative Start-ups, Behörden und Fortune-500-Unternehmen vertrauen auf Apryse





Für KI- und automatisierte Workflows mit hohem Dokumentenaufkommen entwickelt
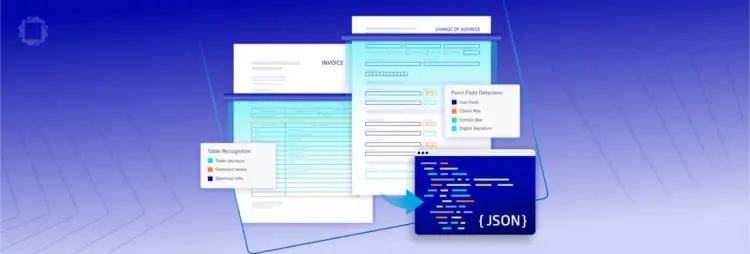
Die Intelligente Datenextraktion erkennt Strukturen in komplexen Dokumenten, darunter Schlüssel-Wert-Paare, Tabellen und Layouts. Die Ergebnisse stehen in Formaten wie JSON, XML und Excel zur direkten Verarbeitung bereit.

Datenaufbereitung
Bereiten Sie hochwertige Daten für das Fine-Tuning kleiner Sprachmodelle vor – ohne manuelle Kennzeichnung.

RAG und Suche verbessern
Konvertieren Sie große Dokumente in strukturierte, durchsuchbare Formate und ergänzen Sie relevante Metadaten.

Komplexe Abläufe automatisieren
Automatisieren Sie Prozesse in regulierten Branchen durchgängig, indem Sie strukturierte Daten aus beliebigen Dokumenten extrahieren.
Keine Vorlagen. Kein Rätselraten.
Extrahieren Sie klar strukturierte und beschriftete Daten aus Formularen, Tabellen und Verträgen – ohne Vorlagen und auch aus schwer lesbaren Scans.
Zentrale Funktionen
Dokumentenklassifizierung
Erkennen Sie den Dokumenttyp automatisch in 18 unterstützten Kategorien, darunter Rechnungen, Belege, Ausweise, Verträge und Notizen. Jede Seite erhält einen Dokumenttyp und einen Wert für die Erkennungsgenauigkeit. So können Teams Dokumente dem passenden Prozess zuordnen, etwa zur Datenextraktion, Prüfung oder internen Verarbeitung.

Dokumente vorbereiten
Optimiert Eingabedateien, etwa durch Begradigen, Drehen und die Verarbeitung mehrspaltiger Layouts. So werden Inhalte vor dem Einsatz der KI für die strukturierte Extraktion vorbereitet.

Schlüssel-Wert-Paare extrahieren
Erkennen Sie Felder wie „Rechnungsnummer“ oder „Patientenname“ in unstrukturierten oder gescannten Dokumenten.

Tabellenerkennung
Extrahieren Sie Zeilen, verbundene Zellen und Zahlen aus komplexen Tabellen – auch bei anspruchsvollen Layouts.
Umfassende Extraktion von Dokumentelementen
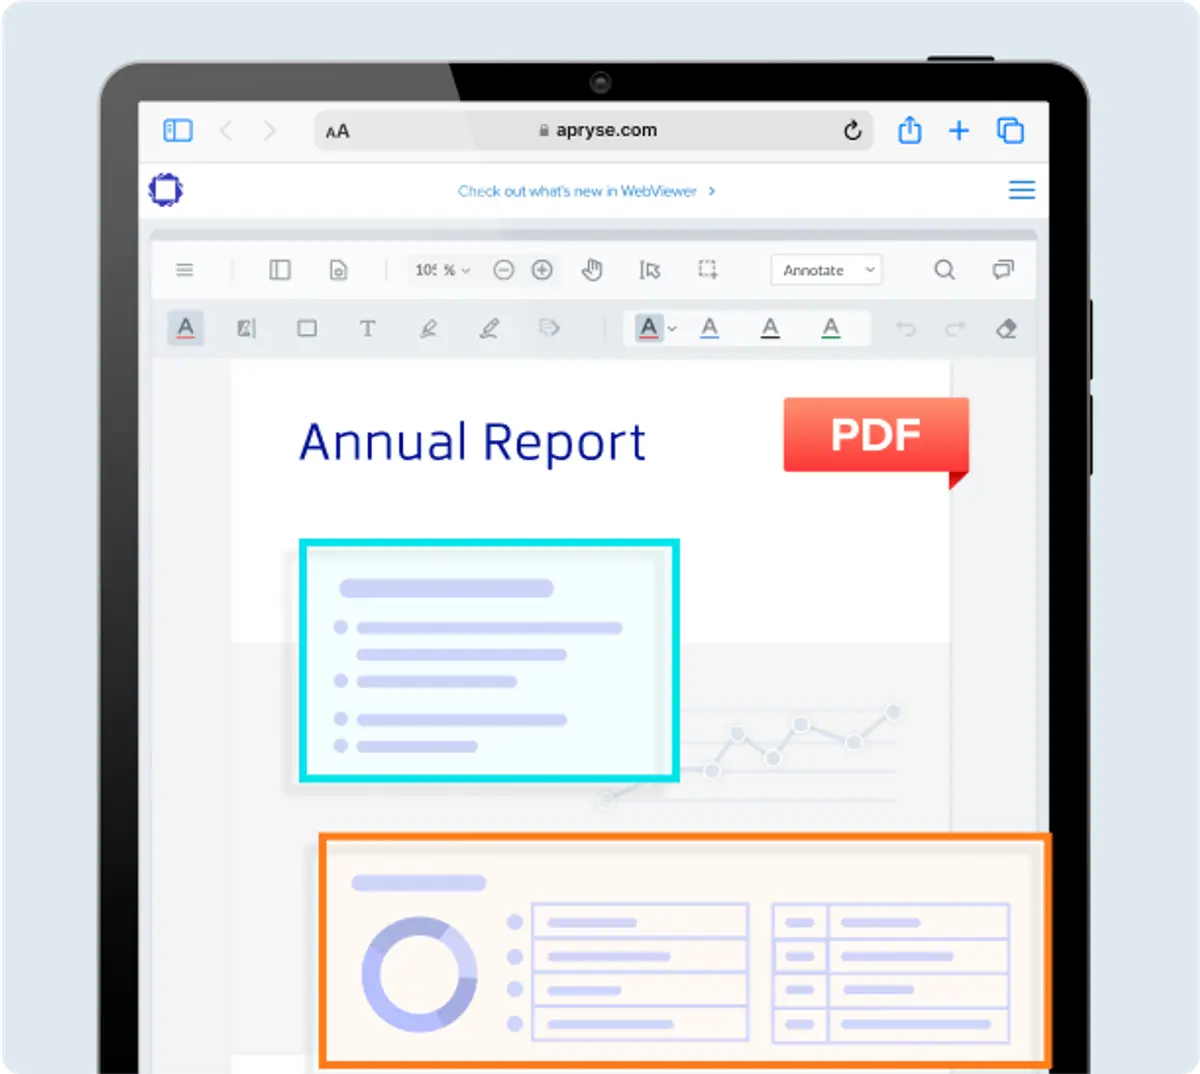
Extrahieren Sie wichtige Inhalte aus PDFs, darunter Text, Bilder, Schriftarten, Ebenen, Signaturen, Formularfelder, Anmerkungen und Metadaten. So bleiben bei der Konvertierung alle relevanten Daten erhalten.
Erkennung von Dokumentstrukturen und Formularfeldern
Erkennen Sie die Struktur von Dokumenten, darunter Überschriften, Absätze und Listen, sowie visuelle Elemente wie Kontrollkästchen und Beschriftungen.
Ausgabeformate
Unterstützt JSON, XML, Excel und CSV – ideal für Analysen, automatisierte Abläufe und das Training von KI-Modellen.
Flexibel bereitstellen
Bereitstellung per SDK. Funktioniert offline, On-Premises, hybrid oder in Air-Gap-Umgebungen. Unterstützt Java, .NET, C++ und Python.
Für KI, Compliance und Kontrolle entwickelt
Vom ersten Tag an für KI gerüstet
Extrahieren Sie Schlüssel-Wert-Paare, Tabellen, Layouts und Strukturen als sauberes JSON oder XML. Die Daten eignen sich für das Training kleiner Sprachmodelle (SLMs), für RAG-Pipelines und für smarte Abläufe.
Datenschutz von Anfang an
Ihre Daten bleiben vollständig in Ihrer eigenen Infrastruktur. Sie behalten jederzeit die volle Kontrolle – ob lokal, in einer Private Cloud oder in isolierten Systemen.
Für Entwickler entwickelt
Nahtlos integrierbar und flexibel anpassbar. Unterstützt PDF, DOCX, Scans und weitere Formate – ohne Vorlagen oder Fachwissen im Bereich maschinelles Lernen.
Semantisches Verständnis
Unsere BERT-basierten Modelle erfassen semantische Zusammenhänge und erkennen relevante Entitäten. So können Sie Daten im richtigen Kontext extrahieren und in KI-Systemen wie RAG-Lösungen und Suchanwendungen effizient weiterverarbeiten.
Technologie für präzise Ergebnisse
Strukturen aus PDFs zu extrahieren, ist anspruchsvoll: Text ist nicht immer auswählbar, Tabellen lassen sich nicht wie in einer Tabellenkalkulation verarbeiten und Felder sind oft nicht mit Tags versehen. Apryse übernimmt diese komplexe Aufgabe für Sie. Im Hintergrund analysiert Apryse mit moderner Computer Vision das Layout, den Inhalt und die Struktur. Für die Erkennung von Tabellen, Feldern und Abschnitten setzen wir auf Objekterkennung in Echtzeit (YOLO – You Only Look Once). BERT-basierte Modelle erfassen den Kontext und die Bedeutung von Texten. Alle Modelle werden nur mit öffentlichen und künstlich erzeugten Daten trainiert. Ihre Dokumente werden zu keinem Zeitpunkt für das Training verwendet.
Möchten Sie Ihre Dokumentenprozesse optimieren?
Entdecken Sie Apryse IDP und optimieren Sie Ihre Dokumentenprozesse. Verbessern Sie die Datenqualität, entwickeln Sie Ihre Modelle für maschinelles Lernen weiter und erstellen Sie schnell hochwertige Datensätze – mit einer Lösung, die zu Ihren Anforderungen passt.
Intelligente Dokumentenprozesse ermöglichen
Optimieren Sie Ihre Dokumentenprozesse mit Apryse Intelligent Document Processing. Moderne KI ermöglicht eine präzise, intelligente Datenextraktion. IDP erfordert keine manuelle Einrichtung und macht Ihre Abläufe schneller und effizienter.
Intelligente Datenextraktion
Effiziente Formularverarbeitung
Tabellen erkennen und Daten extrahieren
Ressourcen
Ressourcen für fundierte Entscheidungen

Kontextbezogene LLM-Abfragen mit intelligenter Datenextraktion optimieren
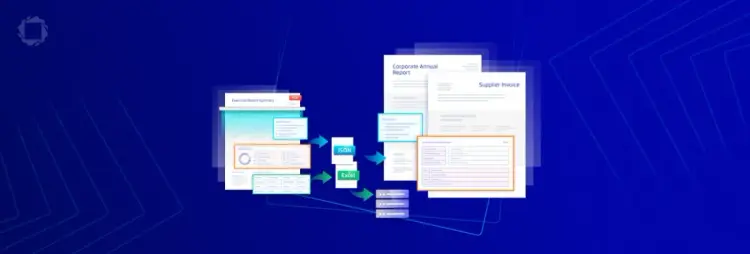
Die neue IDP-Engine und intelligente Datenextraktion von Apryse in der Praxis
KI-Modelle mit der intelligenten Datenextraktion von Apryse gezielter trainieren

